第 7 章 不同的层级,不同的抽象
软件系统由不同层级组成,高层级使用低层级提供的功能。在设计良好的系统中,每一层都提供与其上下层不同的抽象。如果跟踪一个通过方法调用在各层之间传递的操作,就会发现抽象随着每次方法调用而变化。例如:
本章概览相邻两层的接口几乎一样,有什么问题?

- 在文件系统中,最上面的层级实现了文件抽象。文件由可变长度的字节数组组成,可以通过读写可变长度的字节范围来更新该文件。文件系统的下一层级在内存中实现了固定大小的磁盘块的高速缓存。调用者可以假定经常使用的块将保留在内存中,以便可以快速访问它们。最底部的层级由设备驱动程序组成,它们在辅助存储设备和内存之间移动数据块。
- 在 TCP 等网络传输协议中,最上层提供的抽象是在两台机器之间可靠地传输字节流。这一层建立在更低的层级之上,后者以尽力而为的方式,在机器之间传输大小有上限的数据包:大多数数据包能成功送达,但有些可能丢失或乱序到达。
如果系统中的相邻层级具有相似的抽象,这就是一个危险信号,提示类的划分可能存在问题。本章将讨论这种情况出现的场景、带来的问题,以及如何通过重构消除问题。
7.1 透传方法
相邻层级的抽象相似时,问题通常表现为透传方法。这类方法除了调用另一个签名相似或相同的方法,几乎不做其他事情。例如,一个实现图形界面文本编辑器的学生项目中,有一个类几乎完全由透传方法组成。下面是其中的部分代码:
public class TextDocument ... {
    private TextArea textArea;

    private TextDocumentListener listener;
    ...
    public Character getLastTypedCharacter() {
        return textArea.getLastTypedCharacter();
    }
    public int getCursorOffset() {
        return textArea.getCursorOffset();
    }
    public void insertString(String textToInsert, int offset) {
        textArea.insertString(textToInsert, offset);
    }
    public void willInsertString(String stringToInsert, int offset) {
        if (listener != null) {
            listener.willInsertString(this, stringToInsert, offset);
        }
    }
    ...
}
该类的 15 个公有方法中,有 13 个是透传方法。
 危险信号:透传方法

透传方法除了将参数传递给另一个方法外,不执行任何操作;后者通常与它具有相同的 API。这通常表示相关的类之间没有明确的职责划分。
透传方法使类变得更浅:它们增加了类的接口复杂性,进而增加系统的复杂性,却没有增加系统的整体功能。在上述四个方法中,只有最后一个做了一点额外工作,而且微乎其微:检查一个变量是否有效。透传方法还会在类之间建立依赖关系:如果 TextArea 的 insertString 方法更改了签名,就必须相应地修改 TextDocument 中的 insertString 方法。
透传方法表明类之间的职责划分不清。在上面的示例中,TextDocument 类提供了 insertString 方法,但插入文本的功能完全在 TextArea 中实现。这通常不是好的设计:某项功能的接口和实现应该位于同一个类中。当你看到从一个类透传到另一个类的方法时,问问自己:这两个类分别负责哪些功能和抽象?你很可能会发现它们的职责存在重叠。
解决方案是重构这些类,让每个类都承担不同且连贯的职责。图 7.1 展示了几种方法。一种方法如图 7.1(b)所示:让高层级类的调用者直接访问低层级类,使高层级类不再负责这项功能。另一种方法是在类之间重新分配功能,如图 7.1(c)所示。最后,如果这些类的职责无法分开,最好的解决方案可能是将它们合并,如图 7.1(d)所示。
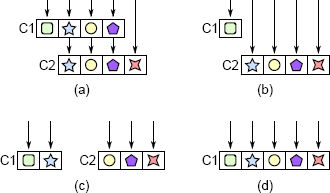
图 7.1:透传方法。在(a)中,类 C1 包含三个透传方法,它们只调用 C2 中具有相同签名的方法(每个符号代表一种方法签名)。要消除透传方法,可以像(b)那样让 C1 的调用方直接调用 C2;也可以像(c)那样在 C1 和 C2 之间重新分配功能,避免两个类之间的调用;还可以像(d)那样将两个类合并。
在上面的示例中,职责交织的三个类是 TextDocument、TextArea 和 TextDocumentListener。学生通过在类之间移动方法,将三个类调整为两个类,消除了透传方法,也让剩下两个类的职责更加明确。
7.2 什么时候可以有重复的接口?
方法具有相同签名,并不一定是坏事。重要的是,每个新方法都应提供有价值的功能。透传方法的问题在于,它们没有提供任何新功能。
分发器(Dispatcher)就是一个有用的例子:它会调用另一个具有相同签名的方法。分发器根据收到的参数,从几个方法中选择一个进行调用,并将大部分或全部参数传给选中的方法。分发器的签名通常与被调用的方法相同,但它仍提供了有用的功能:决定由哪个方法来执行任务。
例如,Web 服务器收到 Web 浏览器发来的 HTTP 请求时,会调用分发器检查请求中的 URL,选择相应的方法来处理请求。某些 URL 只需返回磁盘上的文件内容;其他请求则可能需要调用用 PHP 或 JavaScript 等语言编写的程序。分发过程可能非常复杂,通常依据一组规则来匹配传入的 URL。
只要每个方法都提供了有用且独特的功能,多个方法具有相同签名就是可以接受的。分发器调用的方法就是如此。另一个例子是同一接口的多种实现,例如操作系统中的磁盘驱动程序。不同驱动程序支持不同类型的磁盘,却提供相同的接口。多个方法实现同一接口,可以降低认知负荷:使用过其中一个方法后,再使用其他方法就更容易,因为无需学习新接口。这些方法通常位于同一层级,也不会相互调用。
译者图解签名相同,就一定是透传吗?

7.3 装饰器
装饰器设计模式(也称为“包装器”)会鼓励跨层级重复 API。装饰器对象接收一个现有对象并扩展其功能,提供与底层对象相似或相同的 API,并通过自己的方法调用底层对象的方法。在第 4 章的 Java I/O 示例中,BufferedInputStream 类就是一个装饰器:给定一个 InputStream 对象,它提供相同的 API,同时加入缓冲功能。例如,调用它的 read 方法读取单个字符时,它会调用底层 InputStream 的 read 方法读取更大的块,并保存多读的字符,供后续 read 调用使用。窗口系统中也有类似例子:Window 类实现简单的不可滚动窗口,ScrollableWindow 类则通过添加水平和垂直滚动条来装饰窗口类。
译者注(勘误):本例的
InputStream和BufferedInputStream操作的是字节,不是字符;原文这里将读取和缓冲的单位称为“字符”,正文照录。参见 Java API 文档。
使用装饰器是为了将类的专用扩展与更通用的核心功能分开。但装饰器类往往很浅:为了少量新功能,引入了大量样板代码,而且通常包含许多透传方法。为每个小功能都创建一个新类,很容易造成装饰器模式的滥用,导致浅类激增,就像 Java I/O 示例那样。
创建装饰器类之前,请考虑以下替代方法:
- 能否直接把新功能加入基础类,而不创建装饰器类?如果新功能比较通用,或者在逻辑上与基础类相关,或者大多数使用基础类的场景也会用到它,这样做就有意义。例如,几乎每个创建 Java
InputStream的人都会创建一个BufferedInputStream,而缓冲本来就是 I/O 的自然组成部分,因此应该合并这些类。 - 如果新功能只针对某个特定用例,将它放入实现该用例的代码,而不单独创建类,是否更合理?
- 你可以将新功能与现有的装饰器合并,而不是创建新的装饰器吗?这将产生一个更深的装饰器类,而不是多个浅的装饰器类。
- 最后,问问自己,新功能是否真的需要包装现有功能,能否将它实现为一个独立于基础类的类?在窗口示例中,滚动条也许可以与主窗口分开实现,而不必包装窗口的所有现有功能。
包装器有时也有意义。例如,系统使用一个无法修改接口的外部类,而应用程序要求另一种接口。这时可以用包装器类转换接口。不过,这种情况并不常见,通常还有比包装器类更好的选择。
7.4 接口与实现
“不同的层级,不同的抽象”规则还适用于类的接口与实现:内部的表示形式,通常应与接口提供的抽象不同。如果两者的抽象相似,这个类可能就不够深。例如,在第 6 章的文本编辑器项目中,大多数团队都按行存储文本,每行单独保存。一些团队还提供 getLine 和 putLine 等方法,围绕行设计文本类的 API。这样一来,文本类就很浅,也不便使用。高层级用户界面经常需要在行中插入文本(例如用户键入内容时),或删除跨行的文本范围。面对文本类面向行的 API,调用者只能自行拆分和拼接行,才能实现这些操作。这些代码并不简单,却在用户界面实现中四处重复。
文本类提供面向字符的接口时,使用起来就容易得多。例如,insert 方法可以在任意位置插入任意字符串(可能包含换行符),delete 方法则可以删除任意两个位置之间的文本。内部仍然按行存储,但拆分和拼接行的复杂性被封装在文本类中。这使类更深,也简化了使用它的高层级代码。这样,文本 API 与面向行的存储机制有了显著差异,而这个差异正体现了类提供的价值。
译者图解按行存储,不必按行暴露

7.5 透传变量
跨层级 API 重复的另一种形式是透传变量,即经过一长串方法向下传递的变量。图 7.2(a)展示了一个数据中心服务的例子:命令行参数指定用于安全通信的证书。只有调用库方法打开套接字的底层方法 m3 需要这一信息,但它却必须经过 main 到 m3 路径上的所有方法向下传递。因此,cert 变量出现在每个中间方法的签名中。
透传变量会增加复杂性,因为所有中间方法都必须知道它们的存在,即使根本用不到这些变量。此外,每增加一个变量(例如系统最初不支持证书,后来才添加支持),都可能需要修改大量接口和方法,才能让变量沿所有相关路径传递。
消除透传变量并不容易。一种办法是检查最顶层和最底层的方法是否已经共享某个对象。在图 7.2 的数据中心服务示例中,也许已有一个对象保存其他网络通信信息,而且 main 和 m3 都能访问。这样,main 就可以把证书信息存入该对象,而不必经过通往 m3 的所有中间方法传递证书(见图 7.2(b))。不过,这个对象本身也可能是一个透传变量(否则 m3 如何访问它?)。
另一种办法是把信息存入全局变量,如图 7.2(c)所示。这样就无需在方法之间传递信息,但全局变量几乎总会带来其他问题。例如,它使同一进程无法创建同一系统的两个独立实例,因为它们对全局变量的访问会发生冲突。生产环境中也许很少需要多个实例,但测试时通常很有用。
我最常用的方案是引入上下文(Context)对象,如图 7.2(d)所示。上下文保存应用程序的所有全局状态,也就是原本只能用透传变量或全局变量保存的状态。大多数应用程序的全局状态包含多个变量,例如配置选项、共享子系统和性能计数器。每个系统实例有一个上下文对象。因此,同一进程中可以共存多个系统实例,每个实例都有自己的上下文。
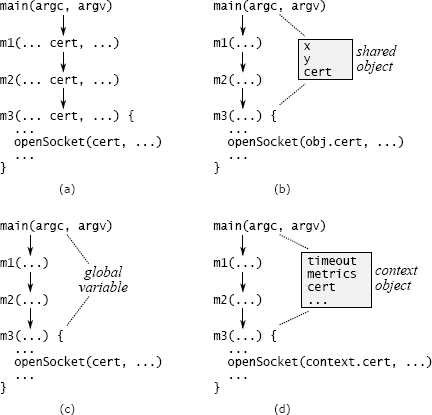
图 7.2:处理透传变量的几种技术。在(a)中,证书经过方法 m1 和 m2 传递,尽管它们并不使用证书。在(b)中,main 和 m3 可以访问同一个对象,因此可以将变量存入该对象,而不必传给 m1 和 m2。在(c)中,证书存储为全局变量。在(d)中,证书与其他系统级信息(如超时值和性能计数器)一起保存在上下文对象中;凡是方法需要访问上下文的对象,都保存一份对上下文的引用。
不幸的是,许多地方都可能需要上下文,因此它本身也可能成为透传变量。为了让更少的方法需要了解上下文,可以让系统中的大多数主要对象保存上下文引用。在图 7.2(d)中,包含 m3 的类将上下文引用保存为实例变量。创建新对象时,负责创建的方法从自身所属对象中取得上下文引用,再传给新对象的构造函数。这样,上下文随处可用,却只需在构造函数中作为显式参数出现。
上下文对象统一管理系统的全局信息,无需使用透传变量。需要添加新变量时,只需将它加入上下文对象;除上下文的构造函数和析构函数外,现有代码都不受影响。全局状态集中存储在一处,也就更容易识别和管理。上下文还便于测试:测试代码可以修改上下文字段,改变应用程序的全局配置。如果使用透传变量,做出这些更改就会困难得多。
上下文远非理想方案。存储在其中的变量仍具有全局变量的大多数缺点。例如,某个变量为什么存在、在哪里使用,可能并不容易看出来。如果缺乏管理,上下文就会堆积大量杂乱数据,在整个系统中形成隐蔽的依赖关系。上下文也可能带来线程安全问题,避免这类问题的最佳办法是让上下文中的变量不可变。遗憾的是,我还没有找到更好的方案。
译者图解不透传之后,两实例会串值吗?

7.6 结论
每向系统添加一个设计元素,例如接口、参数、函数、类或定义,都会增加复杂性,因为开发人员必须了解它。要在降低复杂性方面产生净收益,这个元素就必须消除一些没有它时会存在的复杂性。否则,实现系统时最好不要引入这个元素。例如,类可以通过封装功能降低复杂性,让使用者不必了解具体实现。
“不同的层级,不同的抽象”规则正是这一思想的应用:如果不同层级提供相同的抽象,例如透传方法或装饰器,它们带来的收益就很可能不足以抵消新增设计元素的成本。同样,透传参数要求沿途的多个方法都知道它们的存在,增加了复杂性,却没有提供额外功能。
本章回顾从一个几乎全是透传方法的类,到每一层都提供不同的抽象
