第 10 章 通过定义来规避错误
异常处理是软件系统中最糟糕的复杂性来源之一。处理特殊情况的代码本来就比处理正常情况的代码更难编写,而开发人员在定义异常时,往往没有考虑如何处理它们。本章先讨论异常为何会带来不成比例的复杂性,再介绍如何简化异常处理。本章最重要的启示是:减少必须处理异常的地方。在某些情况下,可以修改操作的语义,让正常行为覆盖所有情况,从而不再有异常情况需要报告(本章标题由此而来)。
本章概览怎样减少必须处理异常的地方?

10.1 为什么异常会增加复杂性
我用“异常”一词指代任何会改变程序正常控制流程的不常见情况。许多编程语言都提供某种形式化的异常机制,允许较低层级的代码抛出异常,再由外层代码捕获。但即使不使用形式化的异常报告机制,也可能发生异常,例如方法返回一个特殊值,表示未能完成正常操作。所有这些形式的异常都会增加复杂性。
一段代码可能因以下几种原因遇到异常:
- 调用方可能会提供错误的参数或配置信息。
- 调用的方法可能无法完成请求的操作。例如,I/O 操作可能失败,或者所需的资源可能不可用。
- 在分布式系统中,网络数据包可能会丢失或延迟,服务器可能无法及时响应,或者节点间可能会以意想不到的方式进行通信。
- 代码可能检测到缺陷(bug)、内部状态不一致,或尚未准备好处理的情况。
大型系统必须应对许多异常情况,分布式系统或需要容错的系统尤其如此。异常处理可能占系统代码的很大一部分。
异常处理代码本来就比正常情况下的代码更难写。异常会中断正常的控制流程,通常意味着某些事情没有按预期运行,操作无法按计划完成。程序员有两种处理方式,但两种都可能很复杂。第一种是尽管出现了异常,仍设法继续完成正在进行的工作。例如,可以重发丢失的网络数据包;数据损坏时,也许可以从冗余副本中恢复。第二种是中止当前操作,向上报告异常。不过,中止操作也可能很复杂,因为异常发生时,系统可能处于不一致的状态(某个数据结构可能只完成了部分初始化)。异常处理代码必须恢复一致性,例如撤销异常发生前所做的更改。
此外,异常处理代码还可能引发更多异常。例如,重发丢失的网络数据包时,原数据包也许并未丢失,只是延迟了。重发就会使对端节点收到重复的数据包,产生新的异常情况,需要该节点处理。再如,从冗余副本恢复丢失的数据时,如果冗余副本也丢失了怎么办?恢复过程中再次发生的异常,往往比最初的异常更加微妙和复杂。如果通过中止当前操作来处理异常,就必须将其作为另一个异常报告给调用方。为了避免异常无休止地级联,开发人员最终必须找到不再引入新异常的处理方式。
编程语言提供的异常处理语法往往冗长而笨拙,使异常处理代码难以阅读。例如,下面的代码利用 Java 对对象序列化和反序列化的支持,从文件中读取 tweet 集合:
try (
    FileInputStream fileStream = new FileInputStream(fileName);
    BufferedInputStream bufferedStream = new BufferedInputStream(fileStream);
    ObjectInputStream objectStream = new ObjectInputStream(bufferedStream);
) {
    for (int i = 0; i < tweetsPerFile; i++) {
        tweets.add((Tweet) objectStream.readObject());
    }
}
catch (FileNotFoundException e) {
    ...
}
catch (ClassNotFoundException e) {
    ...
}
catch (EOFException e) {
    // Not a problem: not all tweet files have full
    // set of tweets.
}
catch (IOException e) {
    ...
}
catch (ClassCastException e) {
    ...
}
即使不算实际处理异常的代码,仅基本的 try-catch 样板代码,行数就超过了正常操作的代码。异常处理代码与正常情况代码之间的对应关系也很难看清,例如,看不出每个异常在哪里产生。另一种做法是将代码拆成多个 try 块。极端情况下,每行可能产生异常的代码都放在单独的 try 块中。这样虽然能明确异常发生的位置,但 try 块本身会打断控制流程,使代码难以阅读。此外,某些异常处理代码还可能在多个 try 块中重复出现。
很难确保异常处理代码真正有效。某些异常(例如 I/O 错误)在测试环境中不容易触发,因此相应的处理代码也很难测试。异常在实际运行的系统中很少发生,异常处理代码也就很少执行。代码缺陷可能长期未被发现,等到真正需要这段代码时,它很可能无法正常工作(我最喜欢的一句话是:“从未执行过的代码是无法工作的”)。最近的一项研究发现,分布式数据密集型系统中超过 90% 的灾难性故障是由不正确的错误处理引起的 [1]。异常处理代码一旦失败,也很难调试,因为问题很少发生。
10.2 异常过多
程序员定义了许多不必要的异常,使异常处理的问题更加严重。大多数程序员都被教导,检测和报告错误很重要,却常将其理解为“检测到的错误越多越好”。这形成了一种过度防御的编程风格:只要遇到稍有可疑的情况,就抛出异常予以拒绝。结果是不必要的异常激增,系统也更加复杂。
设计 Tcl 脚本语言时,我自己就犯过这个错误。Tcl 包含一个用于删除变量的 unset 命令。我将 unset 定义为在变量不存在时抛出错误。当时我认为,试图删除不存在的变量一定意味着代码有缺陷,Tcl 应该报告它。然而,unset 最常见的用途之一,是清理先前操作创建的临时状态。通常很难准确预测创建了哪些状态,尤其是操作中途被中止时。因此,最简单的做法是删除所有可能已经创建的变量。unset 的定义让这种用法变得很麻烦:开发人员最终会用 catch 语句捕获并忽略 unset 抛出的错误。回头来看,unset 命令的设计是我在 Tcl 设计中犯下的最大错误之一。
遇到难处理的情况时,很容易想用异常来回避:与其想出整洁的处理方式,不如抛出异常,把问题交给调用者。有人可能会辩称,这给了调用者更多选择,因为每个调用者都可以用不同的方式处理异常。然而,如果你都不知道该如何处理某种特殊情况,调用者很可能也不知道。这时抛出异常,只会将问题推给别人,增加系统的复杂性。
类抛出的异常是其接口的一部分:抛出大量异常的类,接口更复杂,也比异常较少的类更浅。异常是接口中特别复杂的元素。它在被捕获前可能沿调用栈向上传播多层,因此不仅影响方法的直接调用者,还可能影响更高层级的调用者及其接口。
抛出异常很容易,处理异常却很难,因此异常的复杂性来自处理代码。减少这种复杂性的最佳方法是 减少必须处理异常的地方。本章其余部分将讨论四种减少异常处理程序数量的技术。
10.3 通过定义来规避错误
消除异常处理复杂性的最好方法,是在设计 API 时就让它没有异常需要处理,这就是 通过定义来规避错误。这听起来离经叛道,实践中却非常有效。以上面讨论的 Tcl unset 命令为例。与其让 unset 在删除不存在的变量时抛出错误,不如让它不做任何操作,直接返回。我应该稍微修改 unset 的定义:不是“删除一个变量”,而是“确保一个变量不再存在”。按第一个定义,变量不存在时,unset 无法完成工作,产生异常是合理的。按第二个定义,对不存在的变量名调用 unset 很自然:它的工作已经完成,可以直接返回,不再有错误需要报告。
译者图解改变成功条件,而不是忽略失败

10.4 示例:Windows 中的文件删除
文件删除是通过定义来规避错误的另一个示例。Windows 操作系统不允许删除已被进程打开的文件。这长期困扰着开发人员和用户。为了删除正在使用的文件,用户必须找出打开它的进程,并终止该进程。有时用户会放弃查找,直接重启系统,只为删掉这个文件。
Unix 操作系统对文件删除的定义更优雅。在 Unix 中,如果删除文件时它仍处于打开状态,Unix 不会立即删除它,而是将其标记为删除,然后让删除操作成功返回。文件名会从目录中删除,因此其他进程无法再打开这个旧文件,并且可以创建同名的新文件,但原文件的数据仍会保留。已经打开该文件的进程可以继续正常读写。等所有访问它的进程都关闭文件后,才最终释放其数据。
Unix 删除文件的方式规避了两种错误。首先,文件正在使用时,删除操作会成功返回,而不是报告错误,文件最终也会被删除。其次,删除正在使用的文件,不会让正在使用它的进程抛出异常。另一种可能的做法是立即删除文件,将所有已打开的文件句柄标记为禁用,使其他进程对该文件的读写尝试全部失败。但这又会产生新的错误,需要这些进程处理。相比之下,Unix 允许它们继续正常访问文件,通过延迟删除,在定义上规避了这一错误。
Unix 允许进程继续读写待删除的文件,看起来可能很奇怪,但我从未遇到过因此引发严重问题的情况。对开发人员和用户而言,Unix 的文件删除设计比 Windows 的设计省心得多。
10.5 示例:Java 中的 substring 方法
最后一个示例是 Java 的 String 类及其 substring 方法。给定字符串中的两个索引,substring 方法返回从第一个索引处开始、到第二个索引之前结束的子字符串。但是,只要其中一个索引超出字符串范围,substring 方法就会抛出 IndexOutOfBoundsException。这一异常并无必要,却使方法更难使用。我经常遇到这样的情况:一个或两个索引可能超出字符串范围,但我只想提取字符串中与指定范围重叠的所有字符。不幸的是,我必须检查每个索引,将低于零的索引调到零,将超出字符串末尾的索引调回末尾,使本来只需一行的方法调用变成 5 到 10 行代码。
如果 Java 的子字符串方法能自动完成这种调整,就会更易用。这样,它实现的 API 就是:“返回字符串中索引大于或等于 beginIndex 且小于 endIndex 的字符(如果有)。” 这是一个简单自然的 API,规避了 IndexOutOfBoundsException 异常。即使一个或两个索引为负,或者 beginIndex 大于 endIndex,方法的行为也有明确定义。这种做法既简化了方法的 API,又增加了功能,使方法更深。许多其他语言都采用了这种无错误的方式。例如,Python 对于超出范围的列表切片返回空结果。
译者注(勘误):Python 列表切片的边界越界时,并非一律返回空列表,而是按切片规则调整边界。例如
[1, 2, 3][1:99]返回[2, 3],[1, 2, 3][99:]才返回[]。正文保留原文概括,参见 Python 序列操作说明。
当我主张通过定义来规避错误时,有人会反驳:报告错误有助于发现代码缺陷;如果通过定义消除了错误,会不会让软件出现更多缺陷?也许这就是 Java 开发人员决定让 substring 方法抛出异常的原因。让操作报告错误的做法可能发现一些代码缺陷,但也会增加复杂性,从而引入其他缺陷。采用这种方式时,开发人员必须编写额外代码来避免或忽略错误,这本身就增加了出现缺陷的可能性。如果忘记编写这些代码,运行时又可能出现意外的错误。相比之下,通过定义来规避错误可以简化 API,减少必须编写的代码量。
总体而言,减少代码缺陷的最好方法是简化软件。
译者图解用范围交集定义正常结果

10.6 屏蔽异常
减少异常处理位置的第二种技术是异常屏蔽:在系统的较低层级检测并处理异常情况,让更高层级的软件无需了解这些情况。异常屏蔽在分布式系统中尤其常见。例如,TCP 等网络传输协议可能因数据包损坏或拥塞等原因丢弃数据包。TCP 在实现内部重发丢失的数据包,屏蔽丢包的影响,因此所有数据最终都将送达,客户端不会察觉数据包曾经丢失。
NFS 网络文件系统提供了一个更有争议的异常屏蔽示例。如果 NFS 文件服务器因任何原因崩溃或无法响应,客户端会不断向服务器重发请求,直到问题解决。客户端的底层文件系统代码不会向调用它的应用程序报告异常。当前操作及应用程序只会挂起,直到操作能够成功完成。如果挂起持续了一段时间,NFS 客户端会在用户控制台上输出“NFS 服务器 xyzzy 无法响应,仍在尝试访问”之类的消息。
NFS 用户经常抱怨,应用程序在等待 NFS 服务器恢复时会被挂起。许多人建议,NFS 应该终止操作并抛出异常,而不是挂起。但报告异常只会让情况更糟。无法访问文件时,应用程序也没有什么办法。一种选择是重试文件操作,但这仍会使应用程序挂起;而且,在 NFS 层的一处实现重试,比在每个应用程序的每个文件系统调用处都实现重试更简单(编译器不应操心这种事!)。另一种选择是中止应用程序,将错误返回给调用者。调用者很可能也不知道该怎么办,只能跟着中止,导致用户的工作环境崩溃。文件服务器不可用时,用户依然无法工作;等服务器恢复后,还得重新启动所有应用程序。
因此,最佳选择是让 NFS 屏蔽错误并挂起应用程序。这样,应用程序无需编写任何代码来处理服务器问题,服务器恢复运行后就能继续执行。如果用户不想再等,随时可以手动中止应用程序。
异常屏蔽并非适用于所有情况,但在适用时很有效。它能让类更深:一方面简化了接口,用户需要关注的异常更少;另一方面,通过添加屏蔽异常的代码,增加了类的功能。异常屏蔽是下沉复杂性的一个例子。
10.7 异常聚合
减少异常相关复杂性的第三种技术是异常聚合,即用同一段代码处理多个异常。与其为每个异常分别编写处理程序,不如用一个处理程序在一处集中处理。
考虑 Web 服务器如何处理参数缺失。Web 服务器支持一组 URL。收到传入的 URL 后,服务器会分发给特定的服务方法,由它处理该 URL 并生成响应。该 URL 包含生成响应所需的各种参数。每个服务方法都会调用一个较底层的方法(称为 getParameter),从 URL 中提取所需参数。如果 URL 中没有所需参数,getParameter 就会抛出异常。
软件设计课的学生实现这样的服务器时,许多人会为每次 getParameter 调用单独编写异常处理程序,捕获 NoSuchParameter 异常,如图 10.1 所示。这产生了大量处理程序,而它们做的事基本相同:生成错误响应。
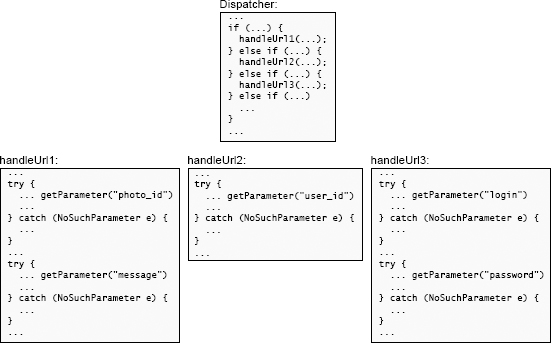
图 10.1:顶部的代码将请求分发给 Web 服务器中的某个方法,每个方法负责一个特定的 URL。底部各方法都使用传入 HTTP 请求中的参数。图中每次 getParameter 调用都有单独的异常处理程序,造成了代码重复。
更好的做法是聚合异常:不在各个服务方法中捕获,而是让异常传播到 Web 服务器的顶层分发方法,如图 10.2 所示。该方法只需一个处理程序,就能捕获所有这些异常,并针对缺失的参数生成适当的错误响应。
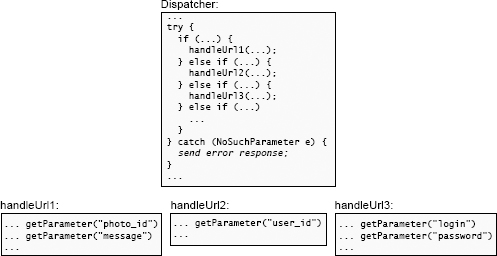
图 10.2:此代码与图 10.1 的功能相同,但聚合了异常处理:分发器中的一个异常处理程序,捕获所有特定于 URL 的方法所抛出的 NoSuchParameter 异常。
在 Web 示例中,还可以进一步聚合异常。处理网页时,除了参数缺失,还可能发生许多其他错误。例如,参数格式不正确(服务方法期望整数,但收到的值是“xyz”),或者用户无权执行请求的操作。这些情况都应返回错误响应,区别仅在于具体的错误消息(“URL 中不存在参数 'quantity'”,或者“'quantity' 参数的值 'xyz' 不正确;必须为正整数”)。因此,所有需要返回错误响应的情况,都可以交给一个顶层异常处理程序。错误消息在抛出异常时生成,作为变量保存在异常记录中。例如,getParameter 会生成“URL 中不存在参数 'quantity'”消息。顶层处理程序从异常中提取消息,将其放入错误响应。
从封装和信息隐藏的角度看,上述异常聚合方式有很好的特性。顶层异常处理程序封装了如何生成错误响应的知识,却不了解具体错误,只使用异常中提供的错误消息。getParameter 方法封装了如何从 URL 提取参数的知识,也知道如何用人能读懂的文字描述提取时的错误。这两部分信息密切相关,适合放在一起。但 getParameter 并不了解 HTTP 错误响应的语法。随着 Web 服务器增加功能,可能会出现更多像 getParameter 这样抛出自身异常的新方法。只要它们抛出的异常与 getParameter 的异常遵循相同约定(继承自同一基类,并包含错误信息),就能直接集成到现有系统中,无需其他修改:顶层异常处理程序会自动为新方法生成相应的错误响应。
译者图解两条错误消息,同一段响应逻辑

这个示例展示了一种通用的异常处理设计模式。如果系统需要处理一系列请求,可以定义一种异常,用来中止当前请求、清理系统状态,然后继续处理下一个请求。系统在请求处理循环的顶层附近集中捕获这种异常。在处理请求的任何时候,都可以抛出它来终止请求,还可以针对不同情况定义不同的异常子类。这类异常应与对整个系统具有致命影响的异常区分开来。
异常沿调用栈向上传播多层后再处理,最能发挥异常聚合的作用,因为这样可以在同一处处理来自更多方法的异常。异常屏蔽则相反,通常在底层代码中处理效果最好。用于屏蔽异常的底层方法通常是供许多其他方法使用的库方法;如果让异常向上传播,就会增加需要处理它的位置。两种方式的共同点是,都将异常处理程序放在能捕获最多异常的位置,从而省去许多原本需要编写的处理程序。
异常聚合的另一个例子是 RAMCloud 存储系统的崩溃恢复。RAMCloud 系统由一组存储服务器组成,这些存储服务器保留每个对象的多个副本,因此系统可以从各种故障中恢复。例如,如果一台服务器崩溃并丢失其所有数据,RAMCloud 会使用存储在其他服务器上的副本来重建丢失的数据。错误也可能在较小的范围内发生。例如,服务器可能发现单个对象已损坏。
RAMCloud 并未为每种错误分别建立恢复机制。相反,RAMCloud 将许多较小的错误“升级”为较大的错误。原则上,RAMCloud 可以从备份副本中恢复损坏的对象,但它并不这样做,而是在发现对象损坏时,让存放该对象的服务器崩溃。RAMCloud 采用这种做法,是因为崩溃恢复非常复杂,而这样可以尽量减少需要实现的恢复机制种类。服务器崩溃恢复机制无论如何都要实现,因此 RAMCloud 也用它处理其他类型的恢复。这既减少了代码量,也让服务器崩溃恢复机制得到更频繁的调用,使其中的代码缺陷更容易被发现和修复。
将对象损坏升级为服务器崩溃,缺点是大幅增加了恢复成本。这对 RAMCloud 不是问题,因为对象损坏非常罕见。但对于经常发生的错误,升级可能并不合适。例如,每丢失一个网络数据包就让服务器崩溃,显然不切实际。
也可以这样理解异常聚合:用一个能处理多种情况的通用机制,替代多个针对特定情况定制的专用机制。这再次说明了通用机制的好处。
10.8 让程序崩溃?
减少异常处理复杂性的第四种技术,是让应用程序崩溃。对大多数应用程序来说,有些错误不值得处理:它们通常很难处理,甚至无法处理,而且很少发生。遇到这些错误时,最简单的做法是打印诊断信息,然后中止应用程序。
例如,分配内存时可能出现“内存不足”错误。C 语言的 malloc 函数在无法分配所需内存块时,会返回 NULL。这种行为并不合适,因为它假定每个 malloc 调用者都会检查返回值,并在内存不足时采取适当措施。应用程序会多次调用 malloc,每次调用后都检查结果,会增加相当大的复杂性。如果程序员忘记检查(这很有可能),内存耗尽时,应用程序就会因解引用空指针而崩溃,反而掩盖了真正的问题。
此外,应用程序发现内存耗尽时,也没有什么办法。原则上,它可以寻找不再需要的内存并释放;但如果有这样的内存,本可以提前释放,从而避免内存不足。当今的系统具有如此大的内存,以至于内存几乎永远不会耗尽。如果真的耗尽,通常说明应用程序存在代码缺陷。因此,很少有理由尝试处理内存不足错误:增加的复杂性太多,收益却太少。
更好的做法是定义一个新的 ckalloc 方法,由它调用 malloc 并检查结果,在内存耗尽时中止应用程序、输出错误消息。应用程序不再直接调用 malloc,而是始终调用 ckalloc。
在较新的语言(例如 C++ 和 Java)中,内存耗尽时,new 运算符会抛出异常。捕获这一异常没有什么意义,因为异常处理程序很可能也会尝试分配内存,同样会失败。动态分配的内存是现代应用程序的基本组成部分,内存耗尽后继续运行没有意义,最好在检测到错误时立即崩溃。
还有许多错误出现时,让应用程序崩溃也是合理的。对大多数程序而言,如果读写已打开的文件时发生 I/O 错误(例如磁盘硬错误),或无法打开网络套接字,通常没有办法从错误中恢复。这时中止程序并输出清晰的错误信息是明智之举。这些错误很少发生,不太可能影响应用程序的整体易用性。如果遇到数据结构不一致等内部错误,中止程序并输出清晰的错误信息也很合适,因为这可能意味着程序存在代码缺陷。
出现某种错误时,能否接受应用程序崩溃,取决于具体的应用程序。对于采用副本机制的存储系统,因 I/O 错误而中止并不合适,系统必须用数据副本恢复丢失的信息。恢复机制会增加相当大的复杂性,但恢复丢失的数据,正是该系统为用户提供的重要价值。
10.9 做过头了
只有模块外部不需要异常信息时,通过定义来规避错误,或在模块内部屏蔽异常,才有意义。本章中的 Tcl unset 命令和 Java substring 方法等示例都是如此。即使在极少数情况下,调用者需要了解异常所检测到的特殊情况,也可以通过其他方式获取这些信息。
但是,有时也会做过头。一个学生团队在网络通信模块中屏蔽了所有网络异常:发生网络错误时,模块将其捕获、丢弃,然后继续执行,仿佛什么都没发生。这样,使用该模块的应用程序就无法判断消息是否丢失,或对端服务器是否发生故障。没有这些信息,就无法构建健壮的应用程序。在这种情况下,即使暴露异常会增加接口的复杂性,模块也必须这样做。
处理异常与软件设计中的许多其他问题一样,必须分清什么重要、什么不重要。不重要的信息应尽量隐藏;重要的信息则必须暴露出来(第 21 章将更详细地讨论这一主题)。
译者图解屏蔽异常不能丢掉完成义务

10.10 结论
任何形式的特殊情况都会使代码更难理解,增加出现代码缺陷的可能性。本章重点讨论了异常这一特殊情况代码的重要来源,以及如何减少必须处理异常的地方。最佳做法是重新定义语义,消除错误条件。对于无法通过定义规避的异常,应寻找机会在底层屏蔽,以限制其影响;或者将多个特殊情况的处理程序聚合成一个更通用的处理程序。综合运用这些技术,可能对系统的整体复杂性产生重大影响。
[1] 丁元 等人,“简单的测试可以防止大多数严重故障:分布式数据密集型系统中的生产故障分析”,2014 USENIX 操作系统设计与实现大会。 ↩
本章回顾从 Tcl 中会报错的 unset 命令,到在定义上让错误消失
