第 10 章 透過定義來規避錯誤
例外處理是軟體系統中最糟糕的複雜性來源之一。處理特殊情況的程式碼本來就比處理正常情況的程式碼更難編寫,而開發人員在定義例外時,往往沒有考慮如何處理它們。本章先討論例外為何會帶來不成比例的複雜性,再介紹如何簡化例外處理。本章最重要的啟示是:減少必須處理例外的地方。在某些情況下,可以修改操作的語義,讓正常行為覆蓋所有情況,從而不再有例外情況需要報告(本章標題由此而來)。
本章概覽怎樣減少必須處理例外的地方?

10.1 為什麼例外會增加複雜性
我用“例外”一詞指代任何會改變程式正常控制流程的不常見情況。許多程式語言都提供某種形式化的例外機制,允許較低層級的程式碼丟擲例外,再由外層程式碼捕獲。但即使不使用形式化的例外報告機制,也可能發生例外,例如方法回傳一個特殊值,表示未能完成正常操作。所有這些形式的例外都會增加複雜性。
一段程式碼可能因以下幾種原因遇到例外:
- 呼叫方可能會提供錯誤的參數或設定資訊。
- 呼叫的方法可能無法完成請求的操作。例如,I/O 操作可能失敗,或者所需的資源可能不可用。
- 在分散式系統中,網路資料包可能會丟失或延遲,伺服器可能無法及時響應,或者節點間可能會以意想不到的方式進行通訊。
- 程式碼可能檢測到缺陷(bug)、內部狀態不一致,或尚未準備好處理的情況。
大型系統必須應對許多例外情況,分散式系統或需要容錯的系統尤其如此。例外處理可能佔系統程式碼的很大一部分。
例外處理程式碼本來就比正常情況下的程式碼更難寫。例外會中斷正常的控制流程,通常意味著某些事情沒有按預期執行,操作無法按計劃完成。程式設計師有兩種處理方式,但兩種都可能很複雜。第一種是儘管出現了例外,仍設法繼續完成正在進行的工作。例如,可以重發丟失的網路資料包;資料損壞時,也許可以從冗餘副本中恢復。第二種是中止當前操作,向上報告例外。不過,中止操作也可能很複雜,因為例外發生時,系統可能處於不一致的狀態(某個資料結構可能只完成了部分初始化)。例外處理程式碼必須恢復一致性,例如撤銷例外發生前所做的更改。
此外,例外處理程式碼還可能引發更多例外。例如,重發丟失的網路資料包時,原資料包也許並未丟失,只是延遲了。重發就會使對端節點收到重複的資料包,產生新的例外情況,需要該節點處理。再如,從冗餘副本恢復丟失的資料時,如果冗餘副本也丟失了怎麼辦?恢復過程中再次發生的例外,往往比最初的例外更加微妙和複雜。如果透過中止當前操作來處理例外,就必須將其作為另一個例外報告給呼叫方。為了避免例外無休止地級聯,開發人員最終必須找到不再引入新例外的處理方式。
程式語言提供的例外處理語法往往冗長而笨拙,使例外處理程式碼難以閱讀。例如,下面的程式碼利用 Java 對物件序列化和反序列化的支援,從檔案中讀取 tweet 集合:
try (
    FileInputStream fileStream = new FileInputStream(fileName);
    BufferedInputStream bufferedStream = new BufferedInputStream(fileStream);
    ObjectInputStream objectStream = new ObjectInputStream(bufferedStream);
) {
    for (int i = 0; i < tweetsPerFile; i++) {
        tweets.add((Tweet) objectStream.readObject());
    }
}
catch (FileNotFoundException e) {
    ...
}
catch (ClassNotFoundException e) {
    ...
}
catch (EOFException e) {
    // Not a problem: not all tweet files have full
    // set of tweets.
}
catch (IOException e) {
    ...
}
catch (ClassCastException e) {
    ...
}
即使不算實際處理例外的程式碼,僅基本的 try-catch 樣板程式碼,行數就超過了正常操作的程式碼。例外處理程式碼與正常情況程式碼之間的對應關係也很難看清,例如,看不出每個例外在哪裡產生。另一種做法是將程式碼拆成多個 try 塊。極端情況下,每行可能產生例外的程式碼都放在單獨的 try 塊中。這樣雖然能明確例外發生的位置,但 try 塊本身會打斷控制流程,使程式碼難以閱讀。此外,某些例外處理程式碼還可能在多個 try 塊中重複出現。
很難確保例外處理程式碼真正有效。某些例外(例如 I/O 錯誤)在測試環境中不容易觸發,因此相應的處理程式碼也很難測試。例外在實際執行的系統中很少發生,例外處理程式碼也就很少執行。程式碼缺陷可能長期未被發現,等到真正需要這段程式碼時,它很可能無法正常工作(我最喜歡的一句話是:“從未執行過的程式碼是無法工作的”)。最近的一項研究發現,分散式資料密集型系統中超過 90% 的災難性故障是由不正確的錯誤處理引起的 [1]。例外處理程式碼一旦失敗,也很難除錯,因為問題很少發生。
10.2 例外過多
程式設計師定義了許多不必要的例外,使例外處理的問題更加嚴重。大多數程式設計師都被教導,檢測和報告錯誤很重要,卻常將其理解為“檢測到的錯誤越多越好”。這形成了一種過度防禦的程式設計風格:只要遇到稍有可疑的情況,就丟擲例外予以拒絕。結果是不必要的例外激增,系統也更加複雜。
設計 Tcl 腳本語言時,我自己就犯過這個錯誤。Tcl 包含一個用於刪除變數的 unset 命令。我將 unset 定義為在變數不存在時丟擲錯誤。當時我認為,試圖刪除不存在的變數一定意味著程式碼有缺陷,Tcl 應該報告它。然而,unset 最常見的用途之一,是清理先前操作建立的臨時狀態。通常很難準確預測建立了哪些狀態,尤其是操作中途被中止時。因此,最簡單的做法是刪除所有可能已經建立的變數。unset 的定義讓這種用法變得很麻煩:開發人員最終會用 catch 語句捕獲並忽略 unset 丟擲的錯誤。回頭來看,unset 命令的設計是我在 Tcl 設計中犯下的最大錯誤之一。
遇到難處理的情況時,很容易想用例外來回避:與其想出整潔的處理方式,不如丟擲例外,把問題交給呼叫者。有人可能會辯稱,這給了呼叫者更多選擇,因為每個呼叫者都可以用不同的方式處理例外。然而,如果你都不知道該如何處理某種特殊情況,呼叫者很可能也不知道。這時丟擲例外,只會將問題推給別人,增加系統的複雜性。
類丟擲的例外是其介面的一部分:丟擲大量例外的類,介面更複雜,也比例外較少的類更淺。例外是介面中特別複雜的元素。它在被捕獲前可能沿呼叫棧向上傳播多層,因此不僅影響方法的直接呼叫者,還可能影響更高層級的呼叫者及其介面。
丟擲例外很容易,處理例外卻很難,因此例外的複雜性來自處理程式碼。減少這種複雜性的最佳方法是 減少必須處理例外的地方。本章其餘部分將討論四種減少例外處理常式數量的技術。
10.3 透過定義來規避錯誤
消除例外處理複雜性的最好方法,是在設計 API 時就讓它沒有例外需要處理,這就是 透過定義來規避錯誤。這聽起來離經叛道,實踐中卻非常有效。以上面討論的 Tcl unset 命令為例。與其讓 unset 在刪除不存在的變數時丟擲錯誤,不如讓它不做任何操作,直接回傳。我應該稍微修改 unset 的定義:不是“刪除一個變數”,而是“確保一個變數不再存在”。按第一個定義,變數不存在時,unset 無法完成工作,產生例外是合理的。按第二個定義,對不存在的變數名呼叫 unset 很自然:它的工作已經完成,可以直接回傳,不再有錯誤需要報告。
譯者圖解改變成功條件,而不是忽略失敗

10.4 範例:Windows 中的檔案刪除
檔案刪除是透過定義來規避錯誤的另一個範例。Windows 作業系統不允許刪除已被行程開啟的檔案。這長期困擾著開發人員和使用者。為了刪除正在使用的檔案,使用者必須找出開啟它的行程,並終止該行程。有時使用者會放棄查詢,直接重啟系統,只為刪掉這個檔案。
Unix 作業系統對檔案刪除的定義更優雅。在 Unix 中,如果刪除檔案時它仍處於開啟狀態,Unix 不會立即刪除它,而是將其標記為刪除,然後讓刪除操作成功回傳。檔名會從目錄中刪除,因此其他行程無法再開啟這個舊檔案,並且可以建立同名的新檔案,但原檔案的資料仍會保留。已經開啟該檔案的行程可以繼續正常讀寫。等所有存取它的行程都關閉檔案後,才最終釋放其資料。
Unix 刪除檔案的方式規避了兩種錯誤。首先,檔案正在使用時,刪除操作會成功回傳,而不是報告錯誤,檔案最終也會被刪除。其次,刪除正在使用的檔案,不會讓正在使用它的行程丟擲例外。另一種可能的做法是立即刪除檔案,將所有已開啟的檔案控制代碼標記為停用,使其他行程對該檔案的讀寫嘗試全部失敗。但這又會產生新的錯誤,需要這些行程處理。相比之下,Unix 允許它們繼續正常存取檔案,透過延遲刪除,在定義上規避了這一錯誤。
Unix 允許行程繼續讀寫待刪除的檔案,看起來可能很奇怪,但我從未遇到過因此引發嚴重問題的情況。對開發人員和使用者而言,Unix 的檔案刪除設計比 Windows 的設計省心得多。
10.5 範例:Java 中的 substring 方法
最後一個範例是 Java 的 String 類及其 substring 方法。給定字串中的兩個索引,substring 方法回傳從第一個索引處開始、到第二個索引之前結束的子字串。但是,只要其中一個索引超出字串範圍,substring 方法就會丟擲 IndexOutOfBoundsException。這一例外並無必要,卻使方法更難使用。我經常遇到這樣的情況:一個或兩個索引可能超出字串範圍,但我只想提取字串中與指定範圍重疊的所有字元。不幸的是,我必須檢查每個索引,將低於零的索引調到零,將超出字串末尾的索引調回末尾,使本來只需一行的方法呼叫變成 5 到 10 行程式碼。
如果 Java 的子字串方法能自動完成這種調整,就會更易用。這樣,它實作的 API 就是:“回傳字串中索引大於或等於 beginIndex 且小於 endIndex 的字元(如果有)。” 這是一個簡單自然的 API,規避了 IndexOutOfBoundsException 例外。即使一個或兩個索引為負,或者 beginIndex 大於 endIndex,方法的行為也有明確定義。這種做法既簡化了方法的 API,又增加了功能,使方法更深。許多其他語言都採用了這種無錯誤的方式。例如,Python 對於超出範圍的列表切片回傳空結果。
譯者注(勘誤):Python 列表切片的邊界越界時,並非一律回傳空列表,而是按切片規則調整邊界。例如
[1, 2, 3][1:99]回傳[2, 3],[1, 2, 3][99:]才回傳[]。正文保留原文概括,參見 Python 序列操作說明。
當我主張透過定義來規避錯誤時,有人會反駁:報告錯誤有助於發現程式碼缺陷;如果透過定義消除了錯誤,會不會讓軟體出現更多缺陷?也許這就是 Java 開發人員決定讓 substring 方法丟擲例外的原因。讓操作報告錯誤的做法可能發現一些程式碼缺陷,但也會增加複雜性,從而引入其他缺陷。採用這種方式時,開發人員必須編寫額外程式碼來避免或忽略錯誤,這本身就增加了出現缺陷的可能性。如果忘記編寫這些程式碼,執行時又可能出現意外的錯誤。相比之下,透過定義來規避錯誤可以簡化 API,減少必須編寫的程式碼量。
總體而言,減少程式碼缺陷的最好方法是簡化軟體。
譯者圖解用範圍交集定義正常結果

10.6 遮蔽例外
減少例外處理位置的第二種技術是例外遮蔽:在系統的較低層級檢測並處理例外情況,讓更高層級的軟體無需瞭解這些情況。例外遮蔽在分散式系統中尤其常見。例如,TCP 等網路傳輸協議可能因資料包損壞或擁塞等原因丟棄資料包。TCP 在實作內部重發丟失的資料包,遮蔽丟包的影響,因此所有資料最終都將送達,客戶端不會察覺資料包曾經丟失。
NFS 網路檔案系統提供了一個更有爭議的例外遮蔽範例。如果 NFS 檔案伺服器因任何原因崩潰或無法響應,客戶端會不斷向伺服器重發請求,直到問題解決。客戶端的底層檔案系統程式碼不會向呼叫它的應用程式報告例外。當前操作及應用程式只會掛起,直到操作能夠成功完成。如果掛起持續了一段時間,NFS 客戶端會在使用者控制台上輸出“NFS 伺服器 xyzzy 無法響應,仍在嘗試存取”之類的訊息。
NFS 使用者經常抱怨,應用程式在等待 NFS 伺服器恢復時會被掛起。許多人建議,NFS 應該終止操作並丟擲例外,而不是掛起。但報告例外只會讓情況更糟。無法存取檔案時,應用程式也沒有什麼辦法。一種選擇是重試檔案操作,但這仍會使應用程式掛起;而且,在 NFS 層的一處實作重試,比在每個應用程式的每個檔案系統呼叫處都實作重試更簡單(編譯器不應操心這種事!)。另一種選擇是中止應用程式,將錯誤回傳給呼叫者。呼叫者很可能也不知道該怎麼辦,只能跟著中止,導致使用者的工作環境崩潰。檔案伺服器不可用時,使用者依然無法工作;等伺服器恢復後,還得重新啟動所有應用程式。
因此,最佳選擇是讓 NFS 遮蔽錯誤並掛起應用程式。這樣,應用程式無需編寫任何程式碼來處理伺服器問題,伺服器恢復執行後就能繼續執行。如果使用者不想再等,隨時可以手動中止應用程式。
例外遮蔽並非適用於所有情況,但在適用時很有效。它能讓類更深:一方面簡化了介面,使用者需要關注的例外更少;另一方面,透過新增遮蔽例外的程式碼,增加了類的功能。例外遮蔽是下沉複雜性的一個例子。
10.7 例外聚合
減少例外相關複雜性的第三種技術是例外聚合,即用同一段程式碼處理多個例外。與其為每個例外分別編寫處理常式,不如用一個處理常式在一處集中處理。
考慮 Web 伺服器如何處理參數缺失。Web 伺服器支援一組 URL。收到傳入的 URL 後,伺服器會分發給特定的服務方法,由它處理該 URL 並生成響應。該 URL 包含生成響應所需的各種參數。每個服務方法都會呼叫一個較底層的方法(稱為 getParameter),從 URL 中提取所需參數。如果 URL 中沒有所需參數,getParameter 就會丟擲例外。
軟體設計課的學生實作這樣的伺服器時,許多人會為每次 getParameter 呼叫單獨編寫例外處理常式,捕獲 NoSuchParameter 例外,如圖 10.1 所示。這產生了大量處理常式,而它們做的事基本相同:生成錯誤響應。
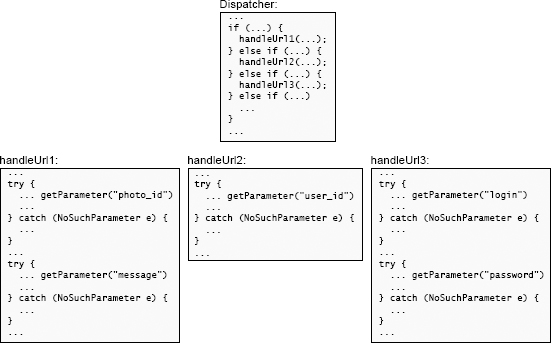
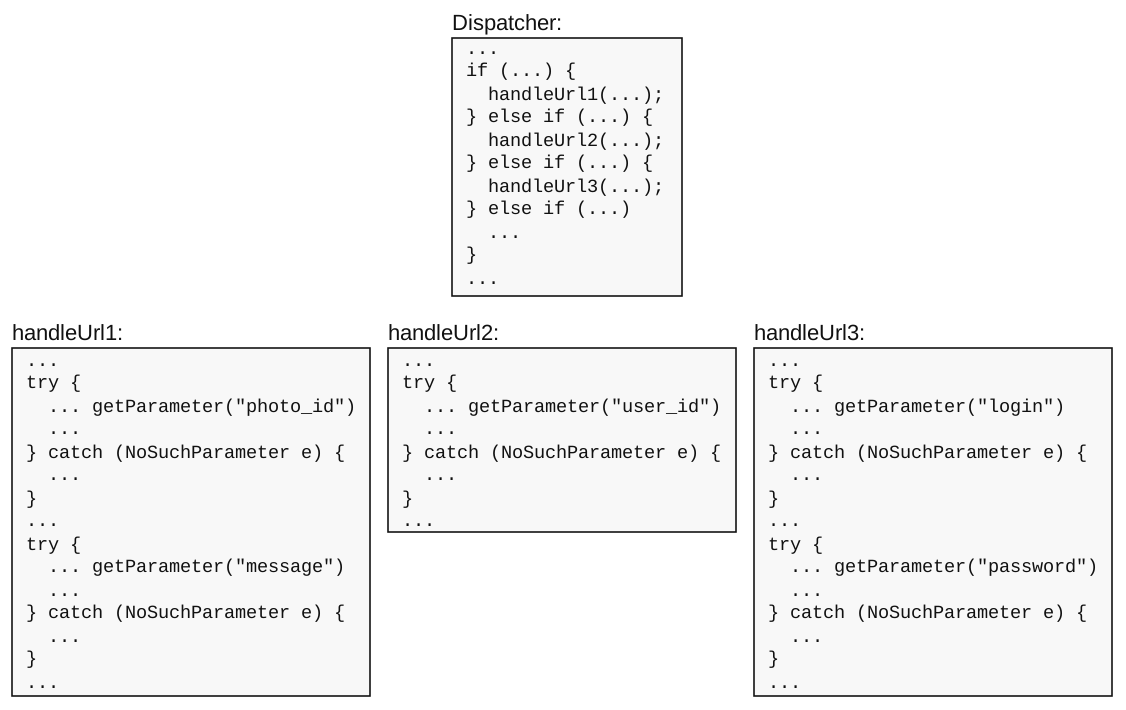
圖 10.1:頂部的程式碼將請求分發給 Web 伺服器中的某個方法,每個方法負責一個特定的 URL。底部各方法都使用傳入 HTTP 請求中的參數。圖中每次 getParameter 呼叫都有單獨的例外處理常式,造成了程式碼重複。
更好的做法是聚合例外:不在各個服務方法中捕獲,而是讓例外傳播到 Web 伺服器的頂層分發方法,如圖 10.2 所示。該方法只需一個處理常式,就能捕獲所有這些例外,並針對缺失的參數生成適當的錯誤響應。
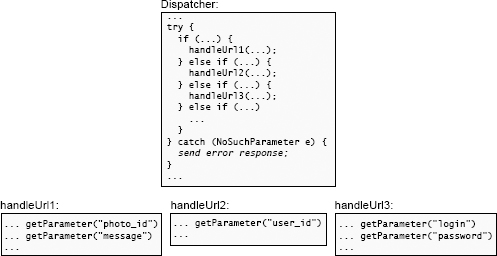
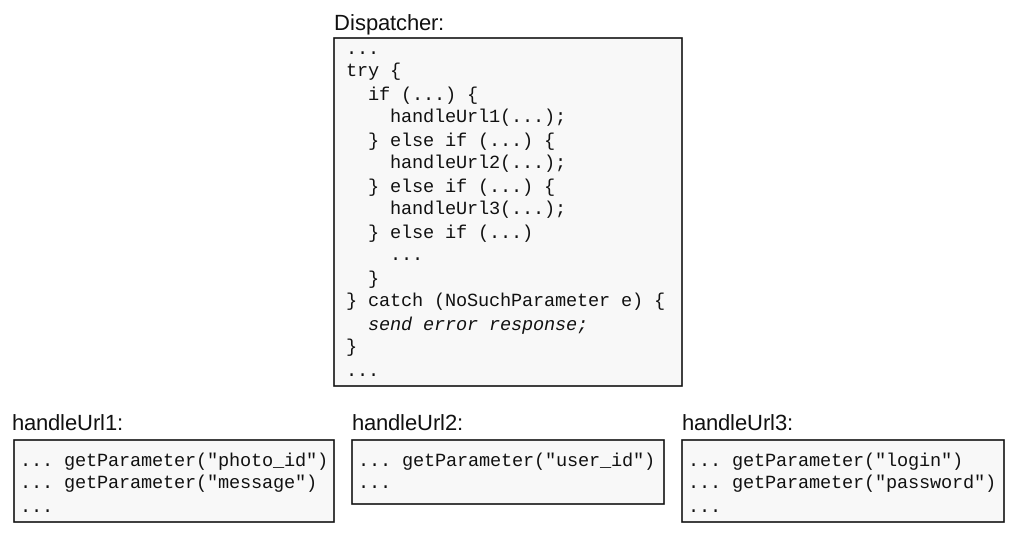
圖 10.2:此程式碼與圖 10.1 的功能相同,但聚合了例外處理:分發器中的一個例外處理常式,捕獲所有特定於 URL 的方法所丟擲的 NoSuchParameter 例外。
在 Web 範例中,還可以進一步聚合例外。處理網頁時,除了參數缺失,還可能發生許多其他錯誤。例如,參數格式不正確(服務方法期望整數,但收到的值是“xyz”),或者使用者無權執行請求的操作。這些情況都應回傳錯誤響應,區別僅在於具體的錯誤訊息(“URL 中不存在參數 'quantity'”,或者“'quantity' 參數的值 'xyz' 不正確;必須為正整數”)。因此,所有需要回傳錯誤響應的情況,都可以交給一個頂層例外處理常式。錯誤訊息在丟擲例外時生成,作為變數儲存在例外記錄中。例如,getParameter 會生成“URL 中不存在參數 'quantity'”訊息。頂層處理常式從例外中提取訊息,將其放入錯誤響應。
從封裝和資訊隱藏的角度看,上述例外聚合方式有很好的特性。頂層例外處理常式封裝了如何生成錯誤響應的知識,卻不瞭解具體錯誤,只使用例外中提供的錯誤訊息。getParameter 方法封裝了如何從 URL 提取參數的知識,也知道如何用人能讀懂的文字描述提取時的錯誤。這兩部分資訊密切相關,適合放在一起。但 getParameter 並不瞭解 HTTP 錯誤響應的語法。隨著 Web 伺服器增加功能,可能會出現更多像 getParameter 這樣丟擲自身例外的新方法。只要它們丟擲的例外與 getParameter 的例外遵循相同約定(繼承自同一基類,並包含錯誤資訊),就能直接整合到現有系統中,無需其他修改:頂層例外處理常式會自動為新方法生成相應的錯誤響應。
譯者圖解兩條錯誤訊息,同一段響應邏輯

這個範例展示了一種通用的例外處理設計模式。如果系統需要處理一系列請求,可以定義一種例外,用來中止當前請求、清理系統狀態,然後繼續處理下一個請求。系統在請求處理迴圈的頂層附近集中捕獲這種例外。在處理請求的任何時候,都可以丟擲它來終止請求,還可以針對不同情況定義不同的例外子類。這類例外應與對整個系統具有致命影響的例外區分開來。
例外沿呼叫棧向上傳播多層後再處理,最能發揮例外聚合的作用,因為這樣可以在同一處處理來自更多方法的例外。例外遮蔽則相反,通常在底層程式碼中處理效果最好。用於遮蔽例外的底層方法通常是供許多其他方法使用的函式庫方法;如果讓例外向上傳播,就會增加需要處理它的位置。兩種方式的共同點是,都將例外處理常式放在能捕獲最多例外的位置,從而省去許多原本需要編寫的處理常式。
例外聚合的另一個例子是 RAMCloud 儲存系統的崩潰恢復。RAMCloud 系統由一組儲存伺服器組成,這些儲存伺服器保留每個物件的多個副本,因此系統可以從各種故障中恢復。例如,如果一台伺服器崩潰並丟失其所有資料,RAMCloud 會使用儲存在其他伺服器上的副本來重建丟失的資料。錯誤也可能在較小的範圍內發生。例如,伺服器可能發現單個物件已損壞。
RAMCloud 並未為每種錯誤分別建立恢復機制。相反,RAMCloud 將許多較小的錯誤“升級”為較大的錯誤。原則上,RAMCloud 可以從備份副本中恢復損壞的物件,但它並不這樣做,而是在發現物件損壞時,讓存放該物件的伺服器崩潰。RAMCloud 採用這種做法,是因為崩潰恢復非常複雜,而這樣可以儘量減少需要實作的恢復機制種類。伺服器崩潰恢復機制無論如何都要實作,因此 RAMCloud 也用它處理其他型別的恢復。這既減少了程式碼量,也讓伺服器崩潰恢復機制得到更頻繁的呼叫,使其中的程式碼缺陷更容易被發現和修復。
將物件損壞升級為伺服器崩潰,缺點是大幅增加了恢復成本。這對 RAMCloud 不是問題,因為物件損壞非常罕見。但對於經常發生的錯誤,升級可能並不合適。例如,每丟失一個網路資料包就讓伺服器崩潰,顯然不切實際。
也可以這樣理解例外聚合:用一個能處理多種情況的通用機制,替代多個針對特定情況定製的專用機制。這再次說明了通用機制的好處。
10.8 讓程式崩潰?
減少例外處理複雜性的第四種技術,是讓應用程式崩潰。對大多數應用程式來說,有些錯誤不值得處理:它們通常很難處理,甚至無法處理,而且很少發生。遇到這些錯誤時,最簡單的做法是列印診斷資訊,然後中止應用程式。
例如,分配記憶體時可能出現“記憶體不足”錯誤。C 語言的 malloc 函式在無法分配所需記憶體塊時,會回傳 NULL。這種行為並不合適,因為它假定每個 malloc 呼叫者都會檢查回傳值,並在記憶體不足時採取適當措施。應用程式會多次呼叫 malloc,每次呼叫後都檢查結果,會增加相當大的複雜性。如果程式設計師忘記檢查(這很有可能),記憶體耗盡時,應用程式就會因解引用空指標而崩潰,反而掩蓋了真正的問題。
此外,應用程式發現記憶體耗盡時,也沒有什麼辦法。原則上,它可以尋找不再需要的記憶體並釋放;但如果有這樣的記憶體,本可以提前釋放,從而避免記憶體不足。當今的系統具有如此大的記憶體,以至於記憶體幾乎永遠不會耗盡。如果真的耗盡,通常說明應用程式存在程式碼缺陷。因此,很少有理由嘗試處理記憶體不足錯誤:增加的複雜性太多,收益卻太少。
更好的做法是定義一個新的 ckalloc 方法,由它呼叫 malloc 並檢查結果,在記憶體耗盡時中止應用程式、輸出錯誤訊息。應用程式不再直接呼叫 malloc,而是始終呼叫 ckalloc。
在較新的語言(例如 C++ 和 Java)中,記憶體耗盡時,new 運算子會丟擲例外。捕獲這一例外沒有什麼意義,因為例外處理常式很可能也會嘗試分配記憶體,同樣會失敗。動態分配的記憶體是現代應用程式的基本組成部分,記憶體耗盡後繼續執行沒有意義,最好在檢測到錯誤時立即崩潰。
還有許多錯誤出現時,讓應用程式崩潰也是合理的。對大多數程式而言,如果讀寫已開啟的檔案時發生 I/O 錯誤(例如磁碟硬錯誤),或無法開啟網路套接字,通常沒有辦法從錯誤中恢復。這時中止程式並輸出清晰的錯誤資訊是明智之舉。這些錯誤很少發生,不太可能影響應用程式的整體易用性。如果遇到資料結構不一致等內部錯誤,中止程式並輸出清晰的錯誤資訊也很合適,因為這可能意味著程式存在程式碼缺陷。
出現某種錯誤時,能否接受應用程式崩潰,取決於具體的應用程式。對於採用副本機制的儲存系統,因 I/O 錯誤而中止並不合適,系統必須用資料副本恢復丟失的資訊。恢復機制會增加相當大的複雜性,但恢復丟失的資料,正是該系統為使用者提供的重要價值。
10.9 做過頭了
只有模組外部不需要例外資訊時,透過定義來規避錯誤,或在模組內部遮蔽例外,才有意義。本章中的 Tcl unset 命令和 Java substring 方法等範例都是如此。即使在極少數情況下,呼叫者需要了解例外所檢測到的特殊情況,也可以透過其他方式獲取這些資訊。
但是,有時也會做過頭。一個學生團隊在網路通訊模組中遮蔽了所有網路例外:發生網路錯誤時,模組將其捕獲、丟棄,然後繼續執行,彷彿什麼都沒發生。這樣,使用該模組的應用程式就無法判斷訊息是否丟失,或對端伺服器是否發生故障。沒有這些資訊,就無法構建健壯的應用程式。在這種情況下,即使暴露例外會增加介面的複雜性,模組也必須這樣做。
處理例外與軟體設計中的許多其他問題一樣,必須分清什麼重要、什麼不重要。不重要的資訊應儘量隱藏;重要的資訊則必須暴露出來(第 21 章將更詳細地討論這一主題)。
譯者圖解遮蔽例外不能丟掉完成義務

10.10 結論
任何形式的特殊情況都會使程式碼更難理解,增加出現程式碼缺陷的可能性。本章重點討論了例外這一特殊情況程式碼的重要來源,以及如何減少必須處理例外的地方。最佳做法是重新定義語義,消除錯誤條件。對於無法透過定義規避的例外,應尋找機會在底層遮蔽,以限制其影響;或者將多個特殊情況的處理常式聚合成一個更通用的處理常式。綜合運用這些技術,可能對系統的整體複雜性產生重大影響。
[1] 丁元 等人,“簡單的測試可以防止大多數嚴重故障:分散式資料密集型系統中的生產故障分析”,2014 USENIX 作業系統設計與實作大會。 ↩
本章回顧從 Tcl 中會報錯的 unset 命令,到在定義上讓錯誤消失
