第 20 章 效能設計
到目前為止,關於軟體設計的討論都圍繞複雜性展開,目標是使軟體儘可能簡單易懂。但如果你正在開發的系統需要執行得很快,該怎麼辦?效能方面的考慮應如何影響設計過程?本章討論如何在保持設計整潔的同時達到高效能。最重要的仍然是簡單:簡單不僅能改善系統設計,通常也能讓系統執行得更快。
本章概覽追求高效能,設計還能保持整潔嗎?

20.1 如何考慮效能
要解決的第一個問題是:“在正常開發過程中,應該在多大程度上關注效能?”如果試圖最佳化每條語句以追求最快的執行速度,就會拖慢開發,並引入大量不必要的複雜性。此外,許多“最佳化”實際上並不能改善效能。另一方面,如果完全忽略效能問題,低效的設計和實作就容易遍佈程式碼,最終系統的執行耗時很容易達到本來所需時間的 5–10 倍。到了這一步,再回頭改進效能也很困難,因為任何一處改進都難以產生顯著效果。
最好的做法介於這兩個極端之間:利用有關效能的基本知識,選擇“自然高效”而又整潔、簡單的設計方案。關鍵是瞭解哪些操作本身開銷就很大。以下是一些如今仍然開銷較大的操作:
- 網路通訊:即使在資料中心內,一次訊息往返也可能需要 10 到 50 微秒,相當於執行數萬條指令的時間。而廣域網的訊息往返可能需要 10 到 100 毫秒。
- 輔助儲存的 I/O:磁碟的 I/O 操作通常需要 5 到 10 毫秒,相當於執行數百萬條指令的時間。快閃記憶體儲存需要 10 到 100 微秒。新出現的非易失性儲存器耗時可能短至 1 微秒,但這仍然相當於執行大約 2000 條指令的時間。
- 動態記憶體分配(C 語言中的
malloc,C++ 或 Java 中的new)通常涉及分配、釋放和垃圾回收方面的大量開銷。 - 快取缺失:將資料從記憶體提取到處理器片上的快取中需要數百條指令的執行時間;在許多程式中,整體效能受快取缺失的影響程度與受計算開銷的影響程度一樣大。
瞭解哪些操作開銷較大的最好方法,是執行微基準測試,即單獨衡量某個操作開銷的小程式。在 RAMCloud 專案中,我們編寫了一個簡單程式,提供微基準測試框架。建立框架花了幾天時間,但有了它,新增新的微基準測試只需五到十分鐘。這樣,我們積累了幾十個微基準測試,既可以用來了解 RAMCloud 所用現有函式庫的效能,也可以衡量為 RAMCloud 編寫的新類的效能。
大致瞭解哪些操作開銷大、哪些開銷小之後,就可以據此儘量選擇開銷小的操作。在許多情況下,高效的方法與較慢的方法同樣簡單。例如,需要儲存大量按鍵查詢的物件時,可以使用雜湊表或有序對映(ordered map)。函式庫中通常會提供這兩種結構,而且都簡單易用。不過,雜湊表的速度很容易達到有序對映的 5 到 10 倍。因此,除非需要對映(map)的有序性,否則應使用雜湊表。
再看一個例子:在 C 或 C++ 之類的語言中為結構陣列分配記憶體。有兩種做法。一種是讓陣列儲存指向結構的指標,這樣就必須先為陣列分配空間,再為每個結構單獨分配空間。另一種是將結構直接儲存在陣列中,只需為所有內容分配一大塊記憶體,效率要高得多。
如果提高效率的唯一辦法是增加複雜性,選擇就更困難了。如果更高效的設計只增加少量複雜性,而且這些複雜性隱藏在內部,不影響任何介面,那麼這樣做可能是值得的(但要注意:複雜性會逐漸累積)。如果更快的設計大幅增加了實作的複雜性,或使介面更複雜,那麼最好先採用更簡單的方法,等效能成為問題時再最佳化。不過,如果有明確證據表明效能在當前情況下很重要,也可以立即實作更高效的方法。
在 RAMCloud 專案中,我們的總體目標之一,是讓客戶端機器透過資料中心網路存取儲存系統時的延遲儘可能低。因此,我們決定使用特殊的網路硬體,讓 RAMCloud 繞過核心,直接透過網路介面控制器收發資料包。儘管這增加了複雜性,我們還是做出了這個決定,因為先前的測量表明,基於核心的網路通訊太慢,無法滿足需求。在 RAMCloud 系統的其餘部分,大多數地方都能保持設計簡單。把這個大問題“解決好”,其他事情就會容易得多。
一般來說,簡單的程式碼往往比複雜的程式碼執行得更快。如果已經透過定義規避了特殊情況和例外情況,就不再需要檢查這些情況的程式碼,系統也會執行得更快。深類比淺類更高效,因為每次方法呼叫都能完成更多工作。淺類會導致更多跨層級操作,而每次跨越層級都會增加執行開銷。
20.2 修改前(和修改後)的測量
但假設你已經按上述方式設計了系統,它仍然太慢。這時很容易憑直覺猜測效能問題的原因,並匆忙調整程式碼。不要這樣做!程式設計師對效能的直覺並不可靠,即使是經驗豐富的開發人員也不例外。如果憑直覺修改,你會把時間浪費在無法提高效能的事情上,還可能在這個過程中使系統變得更複雜。
進行任何修改之前,請先測量系統當前的執行表現。這有兩個目的。首先,找出效能調整最能產生效果的地方。僅測量系統整體效能是不夠的:它可能說明系統太慢,卻不能說明原因。你需要更深入地測量,查清影響整體效能的具體因素。目標是找出少數具體位置:它們目前耗費大量時間,而你也有改進的思路。第二個目的是建立基線,以便修改後再次測量,確認效能確實得到改善。如果測不出效能差異,就撤銷這些修改(除非它們使系統更簡單)。除非能顯著提高速度,否則保留額外複雜性就沒有意義。
譯者圖解最佳化需要兩種測量證據

20.3 圍繞關鍵路徑進行設計
現在假設你已經仔細分析效能,找到了一段執行緩慢、足以影響整個系統性能的程式碼。改善其效能的最佳方法是進行“根本性的”修改,例如引入快取,或更換演算法(例如在平衡樹和列表之間選擇)。我們讓 RAMCloud 的網路通訊繞過核心,就是一個根本性改進的例子。如果找到了這樣的改進方案,就可以用前面各章討論的設計技術來實作它。
不幸的是,有時找不到根本性的解決辦法。這就引出了本章的核心問題:如何重新設計現有程式碼,使其執行得更快。這應當是最後的手段,不應經常採用,但在某些情況下可能帶來顯著改善。關鍵思想是圍繞關鍵路徑設計程式碼。
首先問自己:在常見情況下,完成所需任務最少要執行多少程式碼?暫時不考慮現有程式碼結構,設想自己正在編寫一個只實作關鍵路徑的新方法,其中只包含最常見情況下必須執行的最少程式碼。現有程式碼可能充滿特殊情況,但在這個練習中,請先忽略它們。關鍵路徑上可能有多個方法呼叫,不妨設想把所有相關程式碼放進一個方法。現有程式碼也可能使用各種變數和資料結構;這裡只考慮關鍵路徑所需的資料,並設想最適合關鍵路徑的資料結構。例如,將多個變數合併為一個值可能是合理的。假設你可以徹底重新設計系統,儘量減少執行關鍵路徑所需的程式碼。我們把這段程式碼稱為“理想的程式碼”。
理想的程式碼可能與現有的類結構衝突,也可能不切實際,但它提供了一個很好的目標:儘可能簡單、快速的程式碼。下一步是尋找一種新設計,在保持結構整潔的同時儘量接近這個目標。可以應用前面各章中的所有設計思想,但要儘量保持理想程式碼的完整性。為了形成整潔的抽象,可能需要在理想程式碼上新增少量程式碼。例如,如果涉及雜湊表查詢,多呼叫一次通用雜湊表類的方法是可以接受的。根據我的經驗,幾乎總能找到既簡潔明瞭、又非常接近理想狀態的設計。
在這個過程中,最重要的事情之一是從關鍵路徑中移除特殊情況。程式碼執行緩慢,通常是因為它必須處理多種情況,而其結構又是為了方便處理所有這些情況而設計的。每個特殊情況都會以額外的條件語句、方法呼叫或兩者兼有的形式,在關鍵路徑上新增程式碼。每增加一處,程式碼就慢一些。為提高效能而重新設計時,應儘量減少需要檢查的特殊情況。理想情況下,開頭有一個 if 語句,一次檢查就能識別所有特殊情況。正常情況下,只做這一次檢查,之後便可執行關鍵路徑,不必再檢查其他特殊情況。如果初始檢查未通過(意味著出現了特殊情況),就轉到關鍵路徑之外的分支處理。特殊情況下效能沒那麼重要,因此可以優先讓處理程式碼保持簡單,不必過於追求效能。
譯者圖解讓特殊情況離開常見路徑

20.4 範例:RAMCloud 緩衝區
來看一個例子:我們優化了 RAMCloud 儲存系統的 Buffer 類,使最常見操作的效能達到原來的約兩倍。
RAMCloud 使用 Buffer 物件管理可變長度的記憶體陣列,例如遠端過程呼叫的請求和響應訊息。Buffer 的設計旨在減少記憶體複製和動態儲存分配的開銷。Buffer 中看上去儲存的是一個線性的位元組陣列,但為了提高效率,它允許底層儲存將其劃分為多個不連續的記憶體塊,如圖 20.1 所示。Buffer 是透過追加資料塊建立的。每個塊要麼是外部的,要麼是內部的。如果塊是外部的,則其儲存空間由呼叫方擁有,Buffer 中儲存對此儲存的引用。外部塊通常用於大型塊,以避免記憶體複製。如果塊是內部的,則 Buffer 擁有該塊的儲存,呼叫者提供的資料將被複製到 Buffer 的內部儲存中。
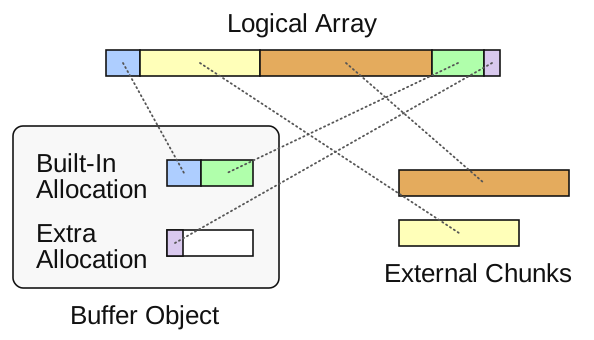
圖 20.1:Buffer 物件用一組記憶體塊儲存線性位元組陣列。內部塊由 Buffer 擁有,在 Buffer 銷燬時釋放;外部塊不屬於 Buffer。
每個 Buffer 都內建一小塊記憶體區域,用於儲存內部塊。如果這部分空間用盡,Buffer 就會分配額外的記憶體區域,並在 Buffer 銷燬時釋放它們。內部塊適合存放少量資料,因為此時記憶體複製的開銷可以忽略不計。圖 20.1 顯示了一個具有 5 個塊的 Buffer:第一個塊是內部的,接下來的兩個塊是外部的,最後兩個塊是內部的。
Buffer 類本身就是一種“根本性的改進”,因為它避免了原本必需的高開銷記憶體複製。例如,在 RAMCloud 儲存系統中組裝包含短標頭和較大物件內容的響應訊息時,RAMCloud 使用帶有兩個塊的 Buffer。第一個是包含標頭的內部塊;第二個是外部塊,引用 RAMCloud 儲存系統中的物件內容。這樣就能在不複製大物件的情況下,將響應組裝到 Buffer 中。
除了允許使用不連續塊這一基本設計外,最初實作時,我們並沒有嘗試最佳化 Buffer 類的程式碼。但隨著時間推移,我們發現 Buffer 的使用越來越頻繁。例如,每次遠端過程呼叫期間,至少會建立四個 Buffer 物件。後來,我們意識到最佳化 Buffer 的實作可能顯著改善系統整體效能,於是決定看看能否提高 Buffer 類的效能。
Buffer 最常見的操作是使用內部塊為少量新資料分配空間,例如為請求和響應訊息建立標頭時。我們決定將這一操作作為最佳化的關鍵路徑。在最簡單的情況下,可以透過擴大 Buffer 中最後一個現有塊來分配空間。但只有當最後一個塊是內部塊,且它所在的記憶體分配區域中仍有足夠空間容納新資料時,這種做法才可行。理想的程式碼只做一次檢查,確認這種簡單做法可行後,就調整現有塊的大小。
圖 20.2 展示了關鍵路徑的原始程式碼,入口是 Buffer::alloc 方法。在最快的使用場景下,Buffer::alloc 呼叫 Buffer::allocateAppend,後者再呼叫 Buffer::Allocation::allocateAppend。從效能角度看,這段程式碼有兩個問題。第一個問題是要分別檢查多種特殊情況,其中有些檢查還重複了。首先,Buffer::allocateAppend 檢查 Buffer 當前是否已有分配的記憶體區域。隨後,程式碼兩次檢查當前記憶體區域是否有足夠空間容納新資料:一次在 Buffer::Allocation::allocateAppend 中,另一次在其回傳值由 Buffer::allocateAppend 檢查時。此外,程式碼沒有嘗試直接擴充最後一個塊,而是不考慮最後一個塊,先分配新空間。然後,Buffer::alloc 再檢查新空間是否恰好與最後一個塊相鄰,如果相鄰就將兩者合併。這會增加額外的檢查。總的來說,程式碼在關鍵路徑上檢查了 6 個不同的條件。
char* Buffer::alloc(int numBytes)
{
    char* data = allocateAppend(numBytes);
    Buffer::Chunk* lastChunk = this->chunksTail;
    if ((lastChunk != NULL && lastChunk->isInternal()) &&
            (data - lastChunk->length == lastChunk->data)) {
        // Fast path: grow the existing Chunk.
        lastChunk->length += numBytes;
        this->totalLength += numBytes;
    } else {
        // Creates a new Chunk out of the allocated data.
        append(data, numBytes);
    }
    return data;
}

// Allocates new space at the end of the Buffer; uses space at the end
// of the last current allocation, if possible; otherwise creates a
// new allocation. Returns a pointer to the new space.
char* Buffer::allocateAppend(int size) {
    void* data;
    if (this->allocations != NULL) {
        data = this->allocations->allocateAppend(size);
        if (data != NULL) {
            // Fast path
            return data;
        }
    }
    data = newAllocation(0, size)->allocateAppend(size);
    assert(data != NULL);
    return data;
}

// Tries to allocate space at the end of an existing allocation. Returns
// a pointer to the new space, or NULL if not enough room.
char* Buffer::Allocation::allocateAppend(int size) {
    if ((this->chunkTop - this->appendTop) < size)
        return NULL;
    char *retVal = &data[this->appendTop];
    this->appendTop += size;
    return retVal;
}
圖 20.2:使用內部塊在 Buffer 的末尾分配新空間的原始程式碼。
譯者注(勘誤):原圖中的
Buffer::allocateAppend宣告回傳char*,卻將區域變數data宣告為void*並直接回傳。C++ 不允許將void*隱式轉換為char*,實際實作時應使回傳值的型別一致。此處保留原書程式碼;這一型別問題不影響下文對關鍵路徑和呼叫層級的討論。
原始程式碼的第二個問題是層級太多,而且都很淺。這既是效能問題,也是設計問題。除了最初對 Buffer::alloc 的呼叫,關鍵路徑上還有兩個額外的方法呼叫。每次呼叫都耗費時間,其中一個呼叫的結果還必須由呼叫者檢查,又增加了需要考慮的特殊情況。第 7 章討論過,從一個層級轉到另一個層級時,抽象通常應如何變化。但圖 20.2 中三個方法的簽名相同,提供的抽象也基本相同,這是一個危險訊號。Buffer::allocateAppend 幾乎是一個透傳方法,它的唯一作用是在需要時分配新的記憶體區域。額外的層級使程式碼更慢,也更複雜。
為了解決這些問題,我們重構了 Buffer 類,讓設計圍繞對效能最重要的路徑展開。除了上面的分配程式碼,我們還考慮了其他幾個常見執行路徑,例如獲取 Buffer 當前儲存資料的總位元組數。對於每條關鍵路徑,我們都試著找出常見情況下必須執行的最少程式碼,再圍繞這些關鍵路徑設計類的其餘部分。同時,我們應用本書的設計原則來簡化整個類,例如消除淺的層、建立更深的內部抽象,並減少需要檢查的特殊情況。重構後的類比原始版本小 20%(1476 行程式碼,而原始版本為 1886 行)。
圖 20.3 展示了在 Buffer 內部塊中分配空間的新關鍵路徑。新程式碼避免了淺抽象,因此不僅更快,也更容易閱讀。整條路徑由一個方法處理,只做一次檢查就能排除所有特殊情況。為簡化關鍵路徑,新程式碼引入了實例變數 availableAppendBytes,記錄緩衝區最後一個塊之後緊鄰的可用空間大小。如果沒有可用空間,或 Buffer 的最後一個塊不是內部塊,或 Buffer 根本沒有任何塊,availableAppendBytes 就為零。只檢查 availableAppendBytes,就能同時檢查三種特殊情況。圖 20.3 展示的就是處理仍有可用空間這一常見情況所需的最少程式碼。
char* Buffer::alloc(int numBytes) {
    if (this->availableAppendBytes >= numBytes) {
        // There is extra space just after the current
        // last chunk, so we can allocate the new
        // region there.
        Buffer::Chunk* chunk = this->lastChunk;
        char* result = chunk->data + chunk->length;
        chunk->length += numBytes;
        this->availableAppendBytes -= numBytes;
        this->totalLength += numBytes;
        return result;
    }
    // We're going to have to create a new chunk.
    ...
}
圖 20.3:用於在 Buffer 的內部塊中分配新空間的新程式碼。
注意:如果在需要時根據各個塊重新計算緩衝區總長度,就不必更新 totalLength。但對於包含許多塊的大型 Buffer,這樣做開銷很大,而獲取 Buffer 總長度又是一種常見操作。因此,我們選擇在 alloc 中增加少量開銷,以確保隨時都能立即獲取 Buffer 的長度。
譯者圖解一個狀態值如何合併多個判斷?

新程式碼的速度約為舊程式碼的兩倍:使用內部儲存將 1 位元組字串附加到 Buffer 的總時間從 8.8 納秒降低到了 4.75 納秒。許多其他 Buffer 操作也因為這次修改而加快了速度。例如,構建一個新的 Buffer 並在內部儲存中追加一小塊、然後再銷燬 Buffer 的時間從 24 納秒降到了 12 納秒。
20.5 結論
本章最重要的經驗是,整潔的設計與高效能可以兼得。重寫 Buffer 類後,其效能達到原來的兩倍,同時設計得到簡化,程式碼量減少了 20%。複雜的程式碼往往執行緩慢,因為它做了不必要或重複的工作。另一方面,如果程式碼整潔、簡單,系統很可能從一開始就足夠快,無需過多擔心效能。在少數確實需要最佳化效能的情況下,關鍵仍然是簡單:找到對效能最重要的關鍵路徑,並使其儘可能簡單。
本章回顧從又慢又複雜的 Buffer 程式碼,到快約一倍且少兩成程式碼
